Introduction : l'enjeu opérationnel
Déployer un avatar IA vocal sur une borne ou un écran dans un lieu public soulève des contraintes techniques concrètes : bruit ambiant variable, interlocuteurs multilingues, disponibilité 24/7 et exigences de confidentialité. Ce guide propose une démarche opérationnelle pour prendre des décisions pragmatiques sur le choix de l'ASR, le matériel audio, le pipeline de prétraitement et les pratiques de validation et d'exploitation.
L'objectif n'est pas de proposer une solution universelle, mais d'exposer les compromis à évaluer selon le profil d'environnement et les objectifs métier, et de livrer des checklists et runbooks utilisables par des responsables de projet, DSI et intégrateurs.
Pourquoi ce choix est critique
La qualité de la reconnaissance vocale conditionne l'utilisabilité de l'interface vocale. Dans un environnement calme, la plupart des ASR modernes offrent une reconnaissance satisfaisante. En environnements bruyants, la dégradation provient autant de l'acoustique et du positionnement du micro que des limitations du moteur ASR.
Les décisions techniques ont aussi des implications non fonctionnelles : latence, confidentialité des flux audio, coût opérationnel, et facilité de maintenance. Il est donc essentiel d'aborder la conception comme une chaîne composée d'éléments dépendants : capteurs audio, traitement en périphérie, transport vers un service de reconnaissance, et UX de fallback.
Matrice décisionnelle ASR : edge vs cloud
Le premier choix stratégique porte sur l'emplacement du moteur ASR. Un traitement en cloud tend à offrir une reconnaissance plus performante et des mises à jour rapides du modèle, alors qu'une solution en edge réduit la latence et limite l'envoi de flux audio vers des tiers. Le bon choix dépend du profil de bruit, des exigences de confidentialité et des contraintes réseau.
Pour des sites avec connectivité réseau fiable et contraintes de confidentialité tolérables, le cloud facilite la gestion des langues et des moteurs évolutifs. Pour des sites avec latence critique, bande passante restreinte ou exigences fortes de confidentialité, l'ASR en edge peut être préféré dans une configuration adaptée.
Dans la pratique, une architecture hybride est souvent pertinente : prétraitement et détection d'activité vocale (VAD) en local, avec envoi vers un moteur cloud ou edge selon la situation et les politiques de confidentialité. La décision technique doit être formalisée dans le cahier des charges et les SLA réseau.
Microphones et positionnement : mono, array et placement
Le choix du capteur est aussi déterminant que le moteur ASR. Les microphones directionnels simples peuvent suffire en environnement calme, tandis que les arrays microphoniques permettent des techniques avancées de spatialisation et beamforming qui améliorent fortement le rapport signal sur bruit perçu par l'ASR.
Le positionnement physique de l'équipement influence la capture : hauteur, distance à l'utilisateur, obstructions et surfaces réfléchissantes sont des facteurs à considérer lors de l'installation. Le design de la borne et l'ergonomie tactile doivent être pensés conjointement avec l'implantation du micro pour éviter les zones mortes acoustiques.
Considérer un array microphonique pour sites bruyants afin d'activer beamforming et annulation d'écho selon la configuration matérielle.
Privilégier un positionnement proche de la zone d'interaction, avec un marquage visuel clair pour inciter l'utilisateur à parler vers le capteur.
Éviter les emplacements proches de sources de bruit récurrentes (caisse, extracteurs, portes automatiques).
Pipeline de prétraitement audio : VAD, réduction de bruit et beamforming
Avant d'atteindre l'ASR, la chaîne audio doit appliquer plusieurs étapes de traitement pour améliorer la qualité du signal utile. La détection d'activité vocale (VAD) évite d'envoyer du bruit continu vers le moteur et permet de maîtriser la latence. La suppression de bruit adaptative et les filtres de longueurs d'onde contribuent à stabiliser le signal.
Le beamforming exploite un array microphonique pour favoriser la direction de la voix de l'utilisateur et atténuer les sons hors axe. Selon la configuration matérielle, ces traitements peuvent être exécutés en local (edge) ou en cloud. Il est recommandé d'architecturer la chaîne pour que les composants critiques (VAD, annulation d'écho) restent disponibles même en perte de connectivité.
Wake word, VAD et gestion des interactions accidentelles
La combinaison wake word et VAD améliore l'ergonomie : un wake word bien choisi autorise l'écoute active sans capter en permanence le flux vocal. Le wake word peut être exécuté en local pour des raisons de confidentialité et de réactivité, tandis que la détection d'activité vocale gère l'ouverture de la session.
Il faut cependant prévoir des comportements UX clairs pour éviter les déclenchements accidentels en milieu bruyant : feedback visuel/sonore court lors de l'activation, option tactile de démarrage vocal et possibilité de couper le micro via une commande visible ou physique selon le projet.
Détection de langue et stratégie multilingue
La détection automatique de la langue facilite l'accueil multilingue, mais elle peut être perturbée par le bruit et par des phrases courtes. Deux approches complémentaires sont recommandées : proposer un choix explicite de langue via l'interface tactile en début d'interaction, et utiliser une détection automatique comme aide lorsque le signal vocal est suffisamment long et stable.
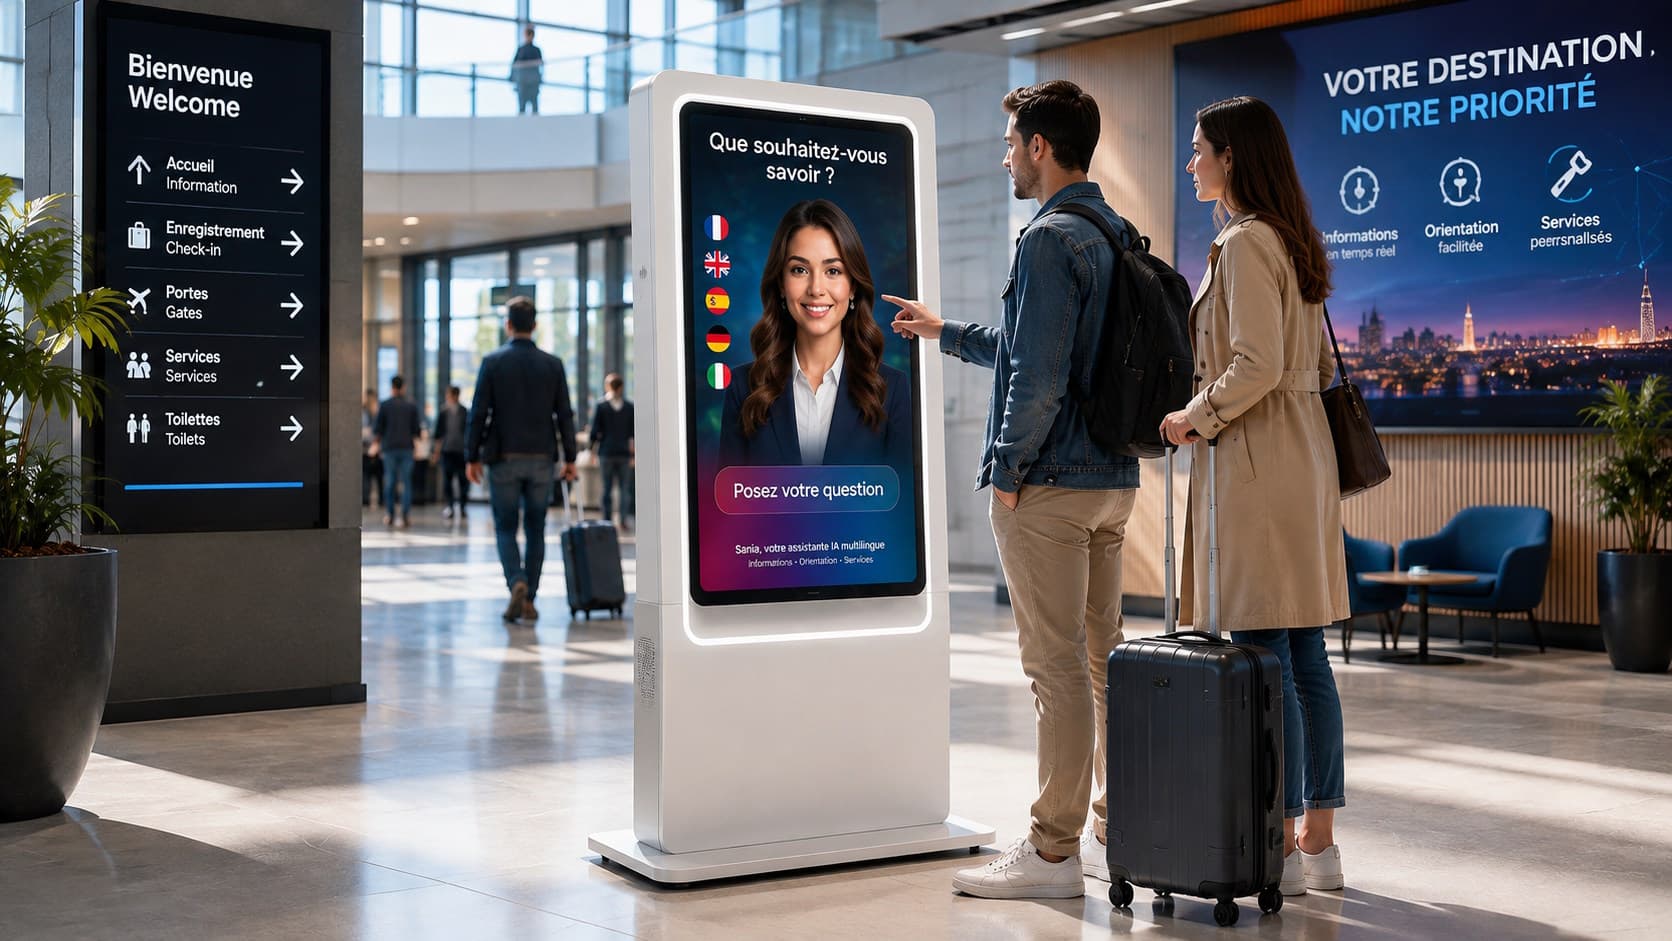
Dans tous les cas, privilégier une UX multimodale : afficher les langues disponibles, permettre un basculement tactile rapide et assurer que la base de connaissances métier est à jour dans les langues pertinentes. SANIA peut communiquer dans plus de 100 langues selon la configuration, ce qui facilite cette mise en œuvre lorsque l'infrastructure ASR supporte les langues cibles.
Fallback tactile et expérience multimodale
Aucun système vocal n'est infaillible en toutes circonstances. Prévoir un fallback tactile ou visuel est indispensable pour maintenir l'accès au service. Par exemple, si la confiance du moteur ASR est basse ou si la détection d'activité réitérée échoue, l'interface doit proposer clairement l'option tactile pour poursuivre la tâche.
L'UX doit rendre fluide la transition voix-tactile : boutons de suggestion, menus contextuels et raccourcis pré-remplis réduisent la charge cognitive. La persona de l'avatar peut guider l'utilisateur vers ces alternatives sans interrompre l'expérience.
Protocoles de tests en conditions réelles
Les tests en laboratoire ne suffisent pas : il faut valider la chaîne vocale sur site, aux heures de fréquentation réelle et avec des locuteurs natifs des langues cibles. Construire des jeux de scénarios représentatifs (questions types, accents, durées d'énonciation) et enregistrer les interactions pour analyse qualitative et correction des points faibles.
Les tests doivent couvrir la résilience réseau, la latence, les taux de faux déclenchements du wake word et les situations de bruit soudain. Les résultats orienteront la calibration du pipeline audio, le choix entre edge et cloud et les réglages de sensibilité du VAD.
Maintenance et runbook 24/7 : checklist opérationnelle
Une exploitation fiable exige des procédures de maintenance claires et accessibles aux équipes locales ou aux prestataires. Le runbook doit décrire les vérifications régulières, les actions d'urgence et les opérations de surveillance permettant d'assurer une disponibilité continue.
Privilégier des procédures simples et reproductibles, et prévoir des moyens de diagnostic à distance selon la configuration. La mise à jour des composants logiciels (drivers audio, firmware de la borne, composants de prétraitement) doit être planifiée et tracée.
Inspection visuelle et nettoyage des grilles microphoniques et haut-parleurs.
Vérification des connexions réseau et alimentation avant intervention sur l'ASR.
Contrôle des logs locaux et extraction périodique des traces audio lorsque la politique de confidentialité le permet.
Vérification des versions logicielles et application contrôlée des correctifs.
Procédure de basculement vers mode tactile si un incident audio persiste.
Configurations types selon le niveau de bruit
Pour faciliter la prise de décision, voici des orientations pratiques par profil acoustique. Elles restent des recommandations générales à adapter au contexte.
Faible bruit : une interface vocale avec micro directionnel et ASR cloud est acceptable. Le prétraitement peut être minimal, et l'UX peut privilégier la voix comme entrée principale.
Bruit moyen : un array microphonique avec beamforming, VAD local et suppression de bruit adaptative améliore la robustesse. Une architecture hybride (prétraitement local, ASR cloud ou edge) est souvent pertinente.
Forte nuisance : privilégier un capteur de qualité (array), traitement local avancé, wake word en edge et stratégie de fallback tactile systématique. La confidentialité peut aussi recommander un traitement local des segments sensibles avant tout envoi.
FAQ courte
Q : Faut-il toujours choisir un array microphonique pour des lieux bruyants ? R : Un array apporte des avantages techniques (beamforming) mais implique un surcoût matériel et une intégration plus stricte. C'est souvent la solution la plus efficace pour des environnements bruyants, mais la décision doit être justifiée par l'usage attendu et le budget du projet.
Q : Comment mesurer que la reconnaissance vocale est
suffisante pour accepter un déploiement ? R : Au-delà des mesures techniques, définir des critères d'acceptation clairs dans votre cahier des charges et valider sur site avec des scénarios représentatifs permet de prendre la décision. Ces critères devraient inclure des taux d'échec perceptibles, la latence d'interaction et la capacité des utilisateurs à atteindre leur objectif via la voix ou le fallback tactile.