Introdução: o desafio operacional
Desenvolver um avatar de voz com IA num totem ou ecrã em espaço público implica restrições técnicas concretas: ruído ambiente variável, utilizadores multilingues, disponibilidade 24/7 e requisitos de confidencialidade. Este guia apresenta um método operacional para tomar decisões pragmáticas sobre ASR, hardware áudio, pipeline de pré‑processamento e práticas de validação e exploração.
O objetivo não é oferecer uma solução universal, mas expor os compromissos a avaliar conforme o perfil do ambiente e os objetivos de negócio, além de fornecer checklists e runbooks úteis para gestores de projeto, responsáveis de TI e integradores.
Por que esta escolha é crítica
A qualidade do reconhecimento de voz condiciona a usabilidade da interface vocal. Em ambiente calmo, a maioria dos ASR modernos oferece reconhecimento satisfatório. Em ambientes ruidosos, a degradação resulta tanto da acústica e posicionamento do microfone quanto das limitações do motor ASR.
As decisões técnicas têm também implicações não funcionais: latência, confidencialidade dos fluxos de áudio, custo operacional e facilidade de manutenção. É, portanto, essencial abordar o desenho como uma cadeia de elementos dependentes: sensores áudio, pré‑processamento na borda, transporte para um serviço de reconhecimento e UX de fallback.
Matriz decisória ASR: edge vs cloud
A primeira escolha estratégica é a localização do motor ASR. Processamento na cloud tende a oferecer reconhecimento mais performante e atualizações rápidas de modelo, enquanto uma solução em edge reduz latência e limita o envio de áudio a terceiros. A escolha adequada depende do perfil de ruído, requisitos de confidencialidade e condições de rede.
Em locais com conectividade fiável e requisitos de privacidade toleráveis, a cloud facilita a gestão de línguas e motores escaláveis. Em locais com latência crítica, largura de banda limitada ou fortes exigências de confidencialidade, o ASR em edge pode ser preferível, com configuração adequada.
Na prática, uma arquitetura híbrida é muitas vezes pertinente: pré‑processamento e deteção de atividade vocal (VAD) localmente, com envio para motor cloud ou edge conforme a situação e as políticas de privacidade. A decisão técnica deve ser formalizada no caderno de encargos e nos SLA de rede.
Microfones e posicionamento: mono, array e colocação
A escolha do sensor é tão determinante quanto o motor ASR. Microfones direcionais simples podem ser suficientes em ambiente calmo, enquanto arrays de microfones permitem técnicas avançadas de espacialização e beamforming que melhoram significativamente a relação sinal/ruído percebida pelo ASR.
O posicionamento físico do equipamento influencia a captação: altura, distância ao utilizador, obstruções e superfícies reflexivas são factores a considerar na instalação. O design do totem e a ergonomia tátil devem ser pensados em conjunto com a implantação do microfone para evitar zonas mortas acústicas.
Considerar um array de microfones para locais ruidosos, para ativar beamforming e cancelamento de eco conforme a configuração de hardware.
Priorizar posicionamento próximo à área de interação, com marcação visual clara para incitar o utilizador a falar para o sensor.
Evitar locais próximos a fontes de ruído recorrentes (caixa, exaustores, portas automáticas).
Pipeline de pré‑processamento áudio: VAD, redução de ruído e beamforming
Antes de chegar ao ASR, a cadeia áudio deve aplicar várias etapas de processamento para melhorar a qualidade do sinal útil. A deteção de atividade vocal (VAD) evita o envio de ruído contínuo para o motor e permite controlar a latência. A supressão adaptativa de ruído e filtros de banda contribuem para estabilizar o sinal.
O beamforming explora um array de microfones para privilegiar a direção da voz do utilizador e atenuar sons fora do eixo. Consoante a configuração de hardware, estes tratamentos podem ser executados localmente (edge) ou na cloud. Recomenda‑se arquitetar a cadeia para que os componentes críticos (VAD, cancelamento de eco) permaneçam disponíveis mesmo em perda de conectividade.
Wake word, VAD e gestão de interações acidentais
A combinação de wake word com VAD melhora a ergonomia: um wake word bem escolhido permite escuta ativa sem capturar permanentemente o fluxo vocal. O wake word pode correr localmente por motivos de privacidade e rapidez, enquanto a deteção de atividade vocal gere a abertura de sessão.
É preciso contudo prever comportamentos UX claros para evitar ativações acidentais em ambientes ruidosos: feedback visual/sonoro curto na ativação, opção tátil de início de voz e possibilidade de desligar o microfone por comando visível ou físico conforme o projeto.
Deteção de idioma e estratégia multilingue
A deteção automática de idioma facilita o acolhimento multilingue, mas pode ser perturbada pelo ruído e por enunciados curtos. Recomenda‑se combinar duas abordagens: oferecer escolha explícita de língua via interface tátil no início da interação e usar deteção automática como apoio quando o sinal vocal for suficientemente longo e estável.
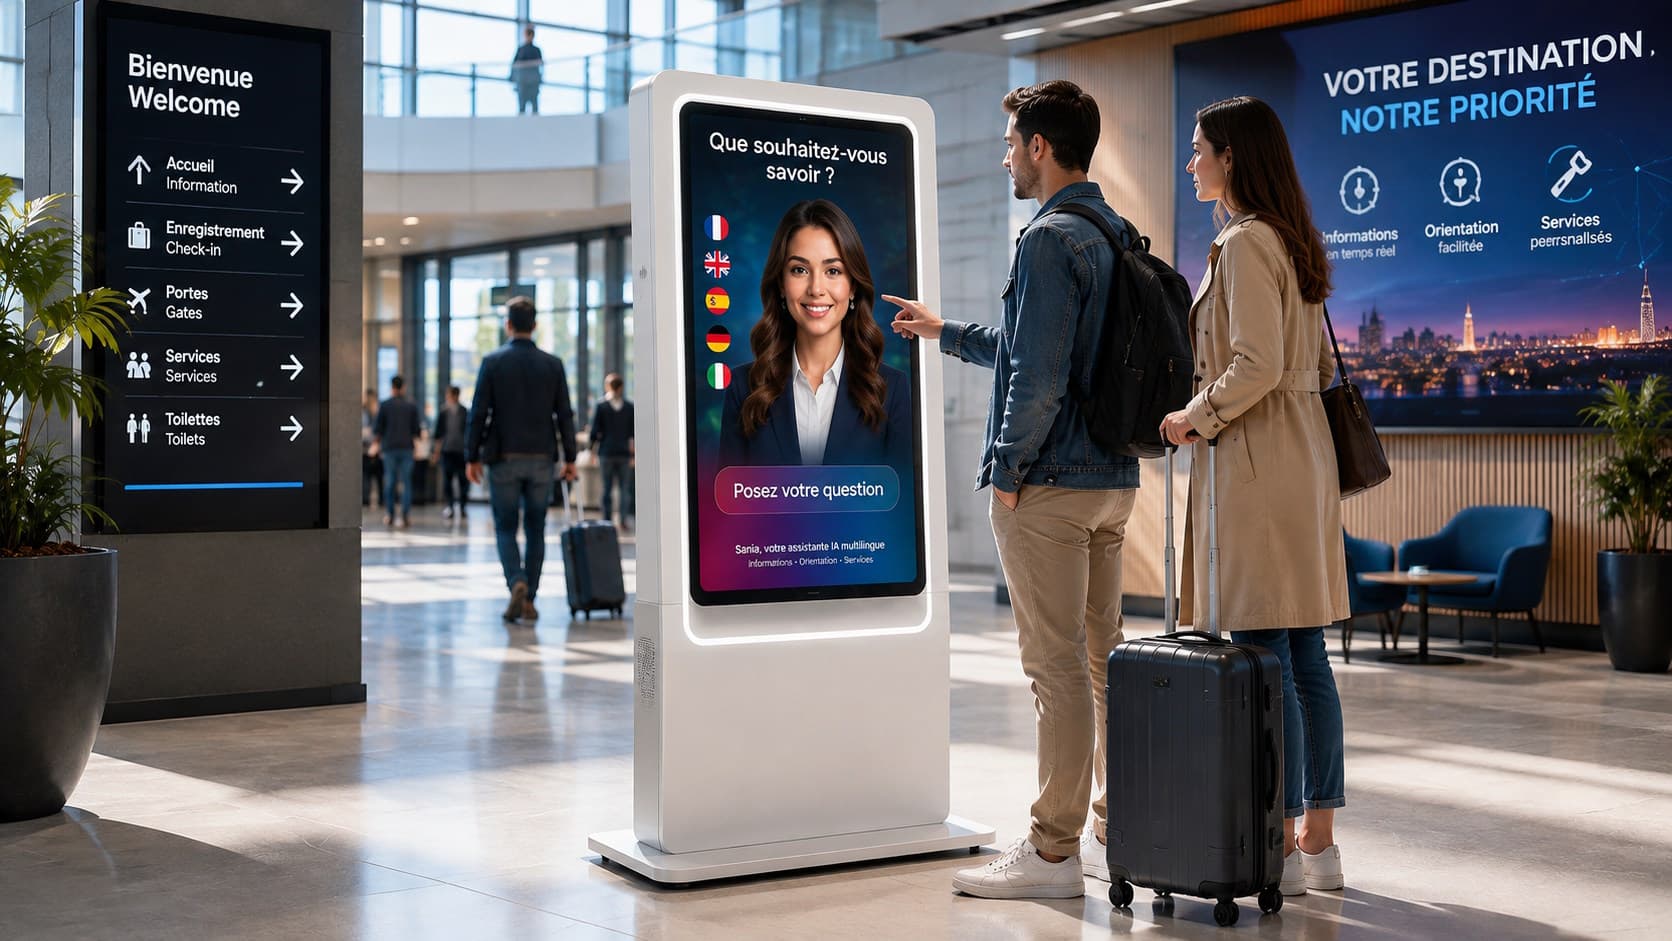
Em todos os casos, privilegiar uma UX multimodal: mostrar as línguas disponíveis, permitir alternância tátil rápida e garantir que a base de conhecimento de negócio está atualizada nas línguas relevantes. SANIA pode comunicar em mais de 100 línguas conforme a configuração, o que facilita esta implementação quando a infraestrutura ASR suporta as línguas alvo.
Fallback tátil e experiência multimodal
Nenhum sistema de voz é infalível em todas as circunstâncias. Prever um fallback tátil ou visual é indispensável para manter o acesso ao serviço. Por exemplo, se a confiança do motor ASR for baixa ou a deteção de atividade vocal falhar repetidamente, a interface deve oferecer claramente a opção tátil para prosseguir a tarefa.
A UX deve tornar fluida a transição voz→tátil: botões de sugestão, menus contextuais e atalhos pré‑preenchidos reduzem a carga cognitiva. A persona do avatar pode guiar o utilizador para essas alternativas sem interromper a experiência.
Protocolos de testes em condições reais
Os testes em laboratório não são suficientes: é necessário validar a cadeia vocal no local, em horas de maior afluência e com falantes nativos das línguas alvo. Construir conjuntos de cenários representativos (perguntas típicas, sotaques, durações de enunciação) e gravar as interações para análise qualitativa e correção de pontos fracos.
Os testes devem cobrir resiliência de rede, latência, taxas de falsos disparos do wake word e situações de ruído súbito. Os resultados orientarão a calibração do pipeline de áudio, a decisão entre edge e cloud e os ajustes de sensibilidade do VAD.
Manutenção e runbook 24/7: checklist operacional
Uma exploração fiável exige procedimentos de manutenção claros e acessíveis às equipas locais ou prestadores. O runbook deve descrever verificações regulares, ações de emergência e operações de monitorização para assegurar disponibilidade contínua.
Privilegie procedimentos simples e reproduzíveis, e preveja meios de diagnóstico remoto segundo a configuração. A atualização dos componentes de software (drivers de áudio, firmware do totem, componentes de pré‑processamento) deve ser planeada e registada.
Inspeção visual e limpeza das grelhas dos microfones e dos altifalantes.
Verificação das ligações de rede e alimentação antes de intervir no ASR.
Controlo dos logs locais e extração periódica de traços de áudio quando a política de privacidade o permitir.
Verificação das versões de software e aplicação controlada de correções.
Procedimento de comutação para modo tátil caso um incidente áudio persista.
Configurações tipo conforme o nível de ruído
Para facilitar a tomada de decisão, seguem‑se orientações práticas por perfil acústico. São recomendações gerais que devem ser adaptadas ao contexto.
Baixo ruído: interface de voz com microfone direcional e ASR na cloud é aceitável. O pré‑processamento pode ser mínimo e a UX pode priorizar a voz como entrada principal.
Ruído médio: um array de microfones com beamforming, VAD local e supressão adaptativa de ruído aumentam a robustez. Uma arquitetura híbrida (pré‑processamento local, ASR cloud ou edge) é frequentemente pertinente.
Alto ruído: priorizar um sensor de qualidade (array), processamento local avançado, wake word no edge e estratégia de fallback tátil sistemática. A confidencialidade pode também recomendar o processamento local de segmentos sensíveis antes de qualquer envio.
FAQ curta
P: Deve‑se sempre optar por um array de microfones em locais ruidosos? R: Um array traz vantagens técnicas (beamforming) mas implica custo adicional de hardware e integração mais rigorosa. É frequentemente a solução mais eficaz para ambientes ruidosos, mas a decisão deve ser justificada pelo uso esperado e pelo orçamento do projeto.
P: Como medir se o reconhecimento de voz é suficiente para aceitar um rollout? R: Para além das medidas técnicas, defina critérios de aceitação claros no caderno de encargos e valide no local com cenários representativos. Esses critérios devem incluir taxas de falha perceptíveis, latência de interação e a capacidade dos utilizadores de atingir o seu objetivo por voz ou por fallback tátil.