Introducción: por qué es imprescindible un marco operativo de medición
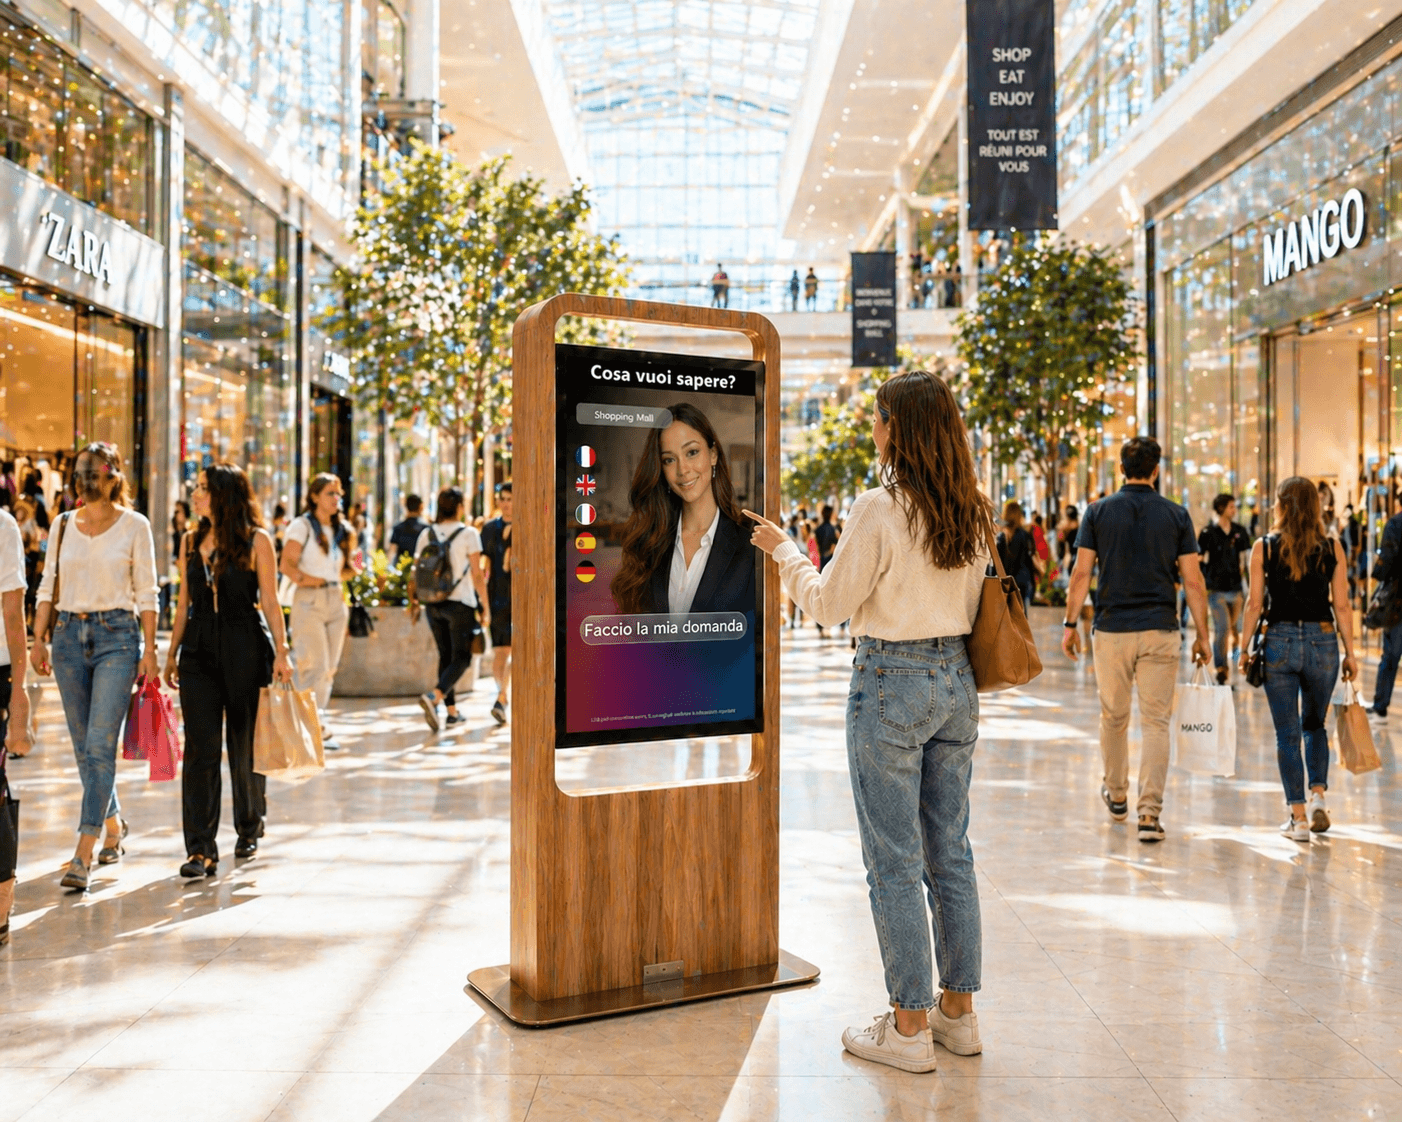
Implemetar un avatar IA en pantalla o kiosco en tienda implica inversiones técnicas y humanas. Los responsables esperan pruebas concretas de valor comercial: impacto en la conversión, en el ticket medio, en la eficiencia de los equipos o en la satisfacción del cliente. Sin un marco de medición claro, un piloto queda como una experimentación anecdótica más que como un palanca estratégica.
Este artículo propone una hoja de ruta práctica para medir el impacto de un avatar IA en tienda: cartografía de objetivos a KPIs, fuentes de datos y patrones de instrumentación, métodos de atribución y experimentación, ejemplos de dashboards operativos, errores frecuentes y un plan de acción para un piloto medible en 8 a 12 semanas.
1. Cartografiar los objetivos de negocio a KPIs accionables
Antes de cualquier instrumentación, identifique un número limitado de objetivos de negocio prioritarios. Traduzca esos objetivos en KPIs medibles y accionables que la dirección y los operativos entenderán.
Ejemplos concretos de correspondencia objetivo‑KPI:
Conversión en tienda: variación de la tasa de conversión global o segmentada (visitantes -> compradores) en zonas equipadas con el avatar frente a control.
Ticket medio y valor transaccional: evolución del ticket medio y del importe medio de las transacciones iniciadas tras una interacción con el avatar, marcadas eventualmente en el POS.
Upsell / cross‑sell: número de ventas adicionales vinculadas a una sugerencia del avatar, medible mediante códigos de recomendación, SKUs etiquetados o notas en POS/CRM.
Tiempo de espera y tiempo útil del personal: reducción de interacciones repetitivas gestionadas por el avatar y horas liberadas para tareas de mayor valor (a evaluar con logs de interacción y registros de RRHH).
Satisfacción y NPS localizado: puntuación de satisfacción post‑interacción (encuestas separadas) o indicadores cualitativos registrados en CRM.
Tráfico y engagement en el punto de interacción: número de interacciones, duración media, tasa de retorno (vuelven a la interfaz) y temas tratados.
2. Fuentes de datos y patrones de instrumentación prácticos
Medir el impacto exige vincular varias fuentes. La idea es obtener señales correlacionadas en lugar de depender de una sola tabla de datos. Aquí están las principales fuentes a considerar y cómo instrumentarlas de forma pragmática.
Logs de interacción del avatar: marca temporal, identificador de sesión anónimo, tipo de interacción (táctil, vocal), intent o tema tratado, duración de la sesión. Estos eventos son el punto de partida para relacionar una interacción con una acción comercial.
POS / caja: transacciones con marca temporal, artículos comprados, importes, códigos promocionales. Una integración específica puede anotarlas como originadas en un canal de asistencia en tienda (por ejemplo mediante un código de origen o un campo libre en la transacción).
CRM y tarjetas de cliente: en retail con programas de fidelidad, el cruce entre sesión de avatar (cuando el usuario se identifica) y registro CRM permite analizar valor del cliente y recurrencia.
Analytics de tienda y footfall: datos de conteo de visitantes, dwell time y heatmaps procedentes de sensores o soluciones de terceros. Estos datos ayudan a contextualizar variaciones de tráfico.
Webhooks y eventos en tiempo real: configurar webhooks para propagar eventos de interacción hacia una plataforma de analytics o un data lake facilita análisis correlacionados.
Fuentes cualitativas: encuestas breves post‑interacción, feedback del equipo, anotaciones de campo. Estas señales ayudan a explicar cambios cuantitativos.
3. Métodos de atribución y experimentación adaptados a la tienda
Atribuir el impacto de un avatar IA en tienda es delicado: los clientes no llegan con una cookie única y muchos factores externos condicionan las ventas. Priorice métodos robustos antes que conclusiones apresuradas.
Se recomiendan tres enfoques complementarios:
Controles geográficos o por punto de venta: comparar tiendas equipadas con tiendas testigo similares (tamaño, mix de producto, zona geográfica). Esto limita sesgos temporales y estacionales.
Ventanas de atribución temporales: definir una ventana lógica durante la cual una interacción pudo influir en una venta (p. ej. interacciones que llevan a una compra en la misma visita o en un periodo definido) y probar varias ventanas para robustez.
Análisis estadísticos de impacto: pruebas de impacto (difference‑in‑differences, uplift analysis) para aislar el efecto del avatar teniendo en cuenta las tendencias generales.
4. Experimentación conversacional y A/B testing en tienda
El A/B testing conversacional es un método potente para demostrar el efecto de una variante de guion, una persona o una opción de sugerencia comercial. En tienda, adapte los principios clásicos al contexto físico.
Aspectos prácticos: aleatorización a escala de la pantalla o del sitio, métricas de éxito vinculadas a los objetivos (transacción iniciada, importe medio, tasa de aceptación de una sugerencia) y duración suficiente para acumular datos explotables. Documente las hipótesis y ejecute las variantes en paralelo para evitar contaminación entre sitios.
5. Modelos de dashboard y cadencia de reporting
Un dashboard convincente separa la vista estratégica (dirección) de la vista operativa (tienda). Proponga tablas claras, con KPIs sintéticos arriba y posibilidades de drilldown por tienda, periodo y tema tratado.
Estructura recomendada:
Vista sintética semanal para la dirección: número de interacciones, tasa de engagement (interacciones / visitantes), impacto estimado en facturación (rango de estimación), indicadores de satisfacción y estado de las experimentaciones.
Vista operativa diaria para managers de tienda: interacciones por kiosco, temas más frecuentes, ventas asociadas etiquetadas, alertas por anomalías (bajada de interacciones, aumento de errores) y recomendaciones de acción en tienda.
Posibilidades de drilldown: por SKU, por segmento de cliente (si CRM está conectado), por tipo de interacción (táctil vs voz) y por escenario conversacional.
6. Errores frecuentes y puntos de atención
Varios errores comunes perjudican la credibilidad de una medición de impacto. Evitarlos es esencial para convencer a la dirección.
Principales puntos de atención:
Sesgo de atribución: confundir correlación con causalidad. Recurra siempre a un diseño experimental o a controles externos cuando sea posible.
Fragmentación de las fuentes: datos inconsistentes entre POS, logs y analytics falsean el análisis. Prevea convenciones comunes de marcas temporales e identificadores de sesión.
Métricas no accionables: seguir únicamente indicadores que no permiten tomar decisiones (por ejemplo, tasa de interacción sin vínculo con una acción comercial no ayuda a medir el ROI).
Efecto Hawthorne y estacionalidad: los comportamientos cambian a veces porque los equipos saben que están observados. Integre periodos de observación largos y tiendas testigo.
7. Plan de acción para un piloto medible en 8 a 12 semanas
Aquí hay un plan pragmático estructurado en tres fases para obtener resultados explotables en un plazo de 8 a 12 semanas.
Fase 1 - Preparación (2 a 4 semanas): definir objetivos prioritarios, elegir KPIs, identificar tiendas piloto y tiendas de control, preparar los esquemas de instrumentación con IT (logs, webhooks, acceso POS/CRM).
Fase 2 - Ejecución del piloto (4 a 6 semanas): desplegar el avatar en los sitios piloto, lanzar los escenarios conversacionales focalizados, activar la recolección de eventos y las integraciones hacia la plataforma de analytics, y ejecutar eventualmente un A/B test conversacional regulado.
Fase 3 - Análisis y consolidación (2 semanas): consolidar datos, realizar análisis de atribución (controles, ventanas temporales, pruebas estadísticas), redactar un informe sintético con recomendaciones operativas y proyección para un despliegue ampliado.
8. Ejemplos de indicadores operativos y reglas de alerta
En lugar de fijar umbrales universales, defina reglas de alerta adaptadas a sus objetivos y a la variabilidad de sus sitios. Algunos indicadores útiles para vigilar de forma continua:
Indicadores a seguir y alertas posibles:
Número de interacciones por día y por kiosco: alerta si caída anómala respecto a la media móvil.
Tasa de completitud de la interacción (interacción iniciada => respuesta útil reconocida): alerta si aumento del drop, signo de un problema de contenido o técnico.
Transacciones asociadas: alerta si incoherencia entre aumento de interacciones y ausencia de cambio en ventas en periodo equivalente.
Feedbacks negativos o solicitudes de ayuda al personal: alerta para acción correctiva rápida.
FAQ
Q1 - ¿Es imprescindible conectar el avatar al POS para medir el impacto comercial?
R1 - No, pero una conexión al POS facilita mucho la atribución directa de transacciones. En ausencia de ello, puede apoyarse en controles de tienda, datos de footfall y análisis estadísticos para estimar el impacto.
Q2 - ¿Cómo gestionar la privacidad y el anonimato al cruzar POS/CRM/logs de interacción?
R2 - Cualquier correlación que implique datos personales debe ser examinada con los equipos jurídicos y el DPO. Priorice la anonimización o el seudonimizado de las sesiones, limite los campos exportados y documente las finalidades del tratamiento antes de cualquier integración.
Conclusión y siguientes pasos prácticos
Medir el impacto de un avatar IA en tienda exige traducir objetivos de negocio en KPIs accionables, orquestar varias fuentes de datos y adoptar métodos de atribución rigurosos. Un piloto estructurado en 8 a 12 semanas, combinando tiendas testigo y análisis estadísticos, permite obtener resultados explotables para la dirección.
SANIA es una solución de avatar IA conversacional profesional que puede desplegarse en pantalla o kiosco interactivo y configurarse para dialogar de forma táctil o vocal. Para estudiar cómo instrumentar un piloto en su entorno, solicite una demostración para validar escenarios prioritarios, integraciones necesarias y KPIs a seguir.