Introducción: por qué el tiempo real exige decisiones de arquitectura
Conectar un avatar IA desplegado en pantalla o terminal con los sistemas de negocio (POS, inventario, CRM, reservas) no es solo cuestión de acceder a APIs. Se trata de asegurar que la información mostrada al visitante sea coherente, esté actualizada y se entregue con una latencia compatible con una interacción conversacional, manteniendo al mismo tiempo el control del coste de las llamadas y garantizando la resiliencia en producción.
Este artículo aborda las decisiones técnicas y organizativas que ayudan a alcanzar estos objetivos: cuándo orquestar los flujos, cuándo preferir una arquitectura orientada a eventos, cómo diseñar APIs y webhooks robustos, qué estrategia de cache adoptar y cómo prever la degradación elegante de la experiencia de usuario. Complementan el contenido runbooks, modelos de pruebas y listas de verificación prácticas.
Orquestación frente a coreografía: elegir el patrón adecuado
Hay dos familias de arquitectura habituales para integrar sistemas de negocio: la orquestación centralizada y la coreografía (arquitectura basada en eventos). Cada enfoque tiene ventajas y límites según la necesidad de coherencia y la naturaleza de los sistemas externos.
Orquestación: un componente central (API Gateway, BFF, orquestador) coordina todas las peticiones a POS, inventario y CRM. Ventajas: visibilidad centralizada de los flujos, control de políticas de retry y cuota, facilidad para gestionar SLO. Límites: riesgo de punto único de fallo y aumento de carga en el orquestador si no está bien dimensionado.
Coreografía: los sistemas se comunican mediante eventos (webhooks, bus de eventos). Ventajas: mejor desacoplamiento, escalabilidad, latencia potencialmente menor para ciertas interacciones. Límites: complejidad en la gestión de la consistencia y las transacciones distribuidas.
Consejo práctico: privilegiar la orquestación para acciones síncronas críticas (verificación de disponibilidad en checkout, reserva instantánea) y la coreografía para la actualización y propagación de estado no bloqueante (sincronización de stock, notificaciones de promoción).
Diseño de APIs y webhooks resilientes
La calidad de las APIs expuestas por los sistemas de negocio y la de los endpoints que usted desarrolle son determinantes. Aquí van reglas de diseño para minimizar errores en producción.
Endpoints idempotentes y verbos claros: para acciones de negocio (reservas, cancelaciones), diseñar APIs idempotentes facilita los reintentos sin riesgo de doble ejecución. Usar identificadores de petición proporcionados por el cliente permite identificar e ignorar duplicados.
Contratos y versionado: documentar con precisión los esquemas (payload, códigos de error) y aplicar un versionado claro evita regresiones durante evoluciones. Los mocks contractuales son útiles para pruebas de integración continuas.
Webhooks resilientes: prever mecanismos de retry en el emisor, backoffs exponenciales y cabeceras de identificación para la validación. Evitar webhooks no autenticados; usar una firma HMAC o un token para validar el origen de las notificaciones.
Cache, invalidación y coherencia: estrategia práctica
El cache reduce la latencia y el coste de las llamadas API, pero introduce el reto de la coherencia. En lugar de una regla universal, aquí hay patrones aplicables según la criticidad de los datos.
Cache de lectura de corta duración: para información no crítica pero consultada con frecuencia (fichas de producto, disponibilidad aproximada), un cache de corta duración puede mejorar la reactividad del avatar. Usar TTL cortos y lógica de validación condicional (ETag/If-Modified-Since) cuando la API lo soporte.
Invalidación por evento: para inventario y promociones, preferir una invalidación proactiva vía webhooks o mensajes de evento enviados por el sistema origen. En cuanto cambie un stock o una promoción, publicar un evento que provoque la invalidación dirigida del cache.
Cache en cliente y edge: en algunas configuraciones, mantener un cache edge (CDN o capa cercana al dispositivo) reduce la latencia percibida. Atención a la coherencia en operaciones transaccionales: para estas, leer la fuente de verdad en lugar del cache.
Gestión de cuotas, latencia y SLO/SLA
Las APIs de POS o de soluciones de reservas pueden imponer cuotas o presentar latencias variables. Para diseñar un servicio robusto, es necesario definir objetivos operativos — sin pretender imponer cifras universales.
Definir SLOs internos para el avatar: por ejemplo, tiempo máximo permitido para responder a una petición exploratoria frente a una acción bloqueante. Estos SLOs sirven para priorizar las llamadas (p. ej., lecturas menos prioritarias) y para elegir el comportamiento de degradación.
Circuit breakers y cuotas: implementar circuit breakers para evitar saturar un servicio tercero en dificultad, y aplicar una estrategia de throttling en el orquestador para respetar las cuotas. Cuando un servicio está restringido, conmutar a datos en cache o proponer una alternativa UX.
Observabilidad de latencias: instrumentar las llamadas externas con trazas y métricas (latencia p95/p99, tasa de error) para detectar degradaciones y activar el runbook adecuado.
Degradación elegante y experiencia de usuario (UX) en caso de indisponibilidad
Cuando los sistemas de negocio no responden, el avatar debe seguir siendo útil. La estrategia UX de degradación es un elemento clave del diseño operacional.
Informar en lugar de ocultar: el avatar puede indicar claramente al visitante que no accede a la información en tiempo real y ofrecer alternativas útiles (información general, horarios, redirección a un servicio humano).
Modos de sustitución: mostrar información del cache (con indicación de frescura), proponer una cita o una pre-solicitud (recopilar datos de contacto para llamada), u ofrecer opciones offline si la integración de una acción no es posible.
Consideraciones vocales: para interacción por voz, prever respuestas breves y prompts de reanudación para evitar que la conversación se bloquee cuando faltan datos externos.
Pruebas, validación y runbook de incidentes
La robustez de una integración se demuestra con pruebas y con la preparación frente a incidentes. Aquí hay un conjunto de métodos de validación y un runbook operativo sintético.
Pruebas automatizadas: incluir pruebas unitarias en los adaptadores de API, pruebas de integración contra mocks contractuales y pruebas end-to-end en entornos que reproduzcan la latencia y los errores de los servicios de negocio.
Pruebas de resiliencia: simular fallos (timeouts, 5xx, cortes de red), cuotas alcanzadas y respuestas corruptas. Las pruebas deben cubrir escenarios de retry, idempotencia y rollback.
Runbook mínimo a preparar (ejemplos de pasos a seguir):
Detectar el incidente mediante alertas (error 5xx, aumento de latencias p99).
Identificar el perímetro afectado (POS, inventario, CRM) y activar un modo degradado configurado para el avatar.
Conmutar endpoints críticos a mocks o a una capa de cache actualizada si es posible.
Notificar a los equipos de negocio y activar el plan de comunicación hacia los sitios impactados.
Registrar las acciones y preparar un post-mortem para corregir los puntos débiles (contratos, timeouts, capacidades).
RAG, multi-LLM y datos en tiempo real: cómo conciliarlos
El uso de una base de conocimiento para enriquecer las respuestas (RAG) y la posibilidad de orquestar varios motores LLM influyen en la manera de integrar datos en tiempo real.
Separar los usos: asignar al motor RAG la información estática o periódica (FAQ, reglas comerciales) e interrogar en directo las APIs de negocio para los datos críticos y volátiles (stock, disponibilidad al instante, reserva).
Contextualización en tiempo real: cuando el avatar debe componer una respuesta que mezcle conocimientos RAG y datos en tiempo real, resolver el orden de las llamadas para limitar la latencia — por ejemplo, llamar primero a la fuente crítica y luego enriquecer con RAG si el presupuesto de latencia lo permite.
Multi-LLM y enrutamiento: según la configuración, puede ser útil enrutar ciertos tipos de peticiones a un LLM especializado (diálogo, síntesis) y otras a un modelo optimizado para verificación factual. Estas decisiones deben probarse para medir el impacto en latencia y coste.
Checklist práctica y ejemplos operativos (retail y hostelería)
Aquí hay una checklist para usar en fase de diseño y preparación del piloto, seguida de dos ejemplos concretos ilustrativos. La checklist apunta a decisiones y validaciones clave antes de poner el avatar en producción.
Checklist de integración:
Identificar los casos de uso síncronos (p. ej.: verificación de stock para compra) y asíncronos (p. ej.: propagación de actualización de precio).
Elegir el patrón de arquitectura principal: orquestación para síncronos / coreografía para propagación de eventos.
Documentar los contratos API y poner en marcha mocks contractuales.
Definir la estrategia de cache y los mecanismos de invalidación (webhooks o mensajes).
Prever circuit breakers, throttling y reglas de retry (con idempotencia).
Preparar el runbook de incidentes y los mensajes UX de degradación; validar con pruebas de usuario si es posible (táctil y vocal).
Ejemplos (ilustrativos)
Retail — disponibilidad de producto y promoción: el avatar consulta el inventario en lectura para indicar la disponibilidad local. Patrón recomendado: orquestador que lee la fuente de inventario para decisiones de checkout, e invalidación del cache vía webhook emitido por el WMS cuando cambian stocks u operaciones de descuento.
Hostelería — reserva y check-in: para una solicitud de reserva, usar una interacción síncrona orquestada hacia el sistema de reservas para obtener una confirmación instantánea. En paralelo, alimentar la base de conocimiento RAG con información no crítica (horarios, servicios) para enriquecer el intercambio.
Conclusión y siguientes pasos
Una integración en tiempo real fiable entre un avatar IA y los sistemas de negocio exige decisiones razonadas sobre la arquitectura (orquestación vs coreografía), APIs y webhooks diseñados para la resiliencia, una estrategia de cache adaptada y runbooks listos para usar. El compromiso entre latencia, coste y coherencia se decide caso por caso según las prioridades del negocio.
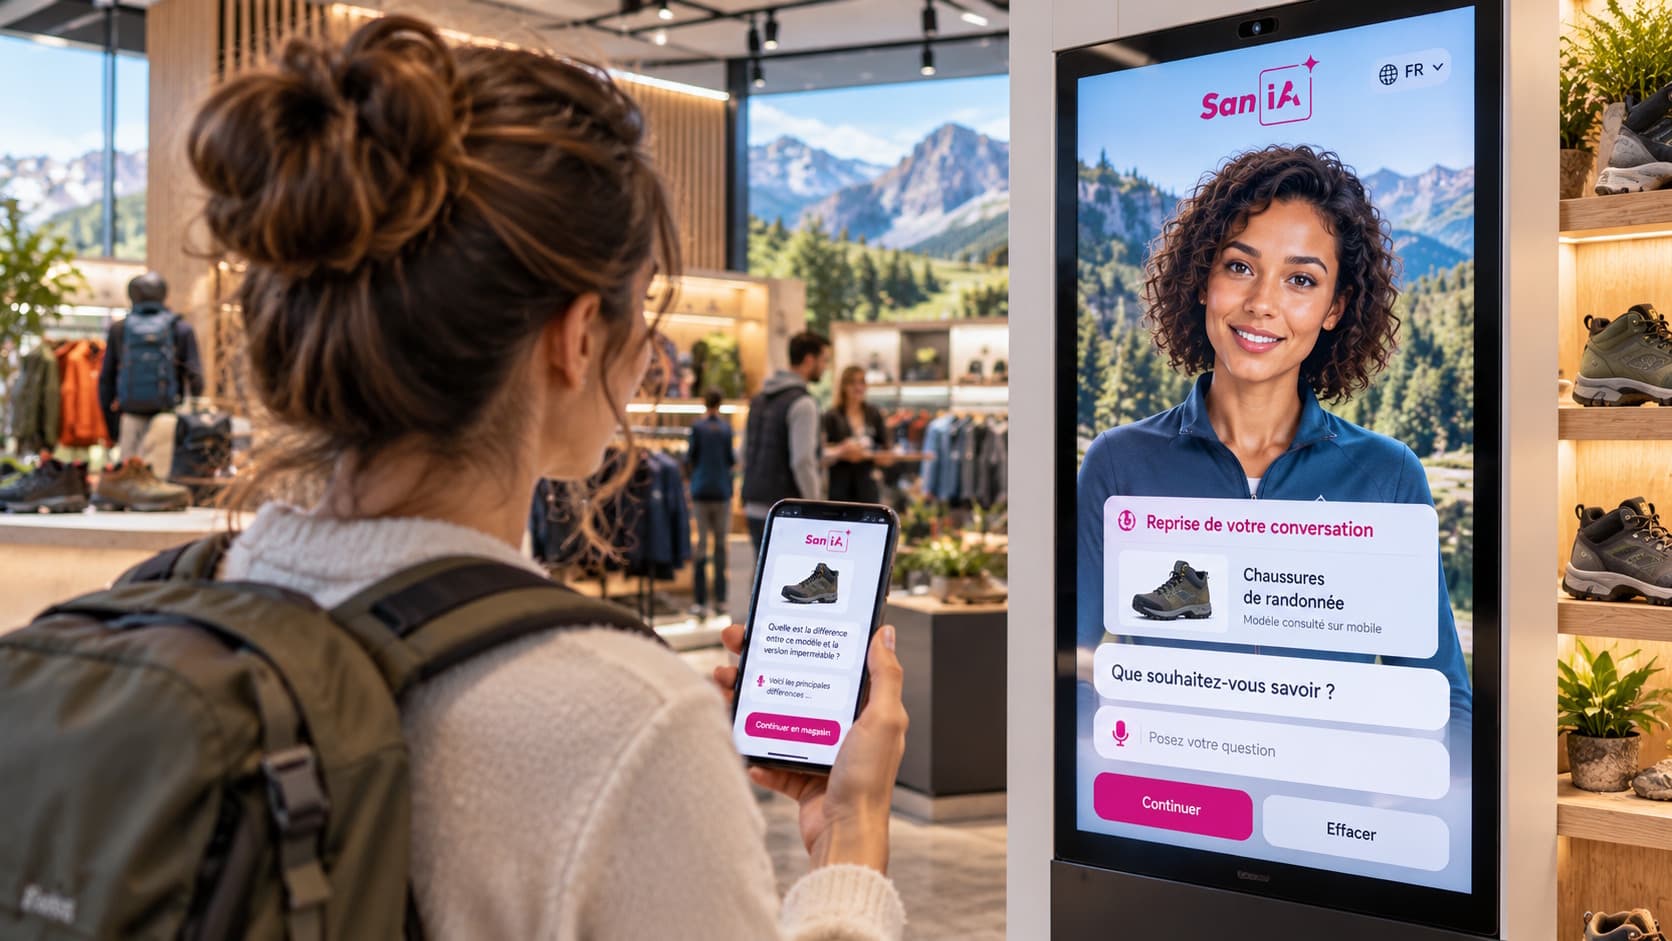
SANIA puede configurarse para interactuar con webhooks, llamar endpoints externos y explotar una base de conocimiento para RAG, a la vez que puede desplegarse en pantallas táctiles/voz o terminales y conectarse con el ecosistema Sandisplay según el proyecto. Para estudiar cómo estos patrones pueden aplicarse a su entorno (retail, hostelería, multi-sitio), puede solicitar una demostración dirigida de SANIA.