Einführung: die operationale Herausforderung
Die Bereitstellung eines sprachfähigen KI‑Avatars an einem Kiosk oder Display in öffentlichen Räumen bringt konkrete technische Zwänge mit sich: variabler Umgebungslärm, mehrsprachige Benutzer, 24/7‑Verfügbarkeit und Datenschutzanforderungen. Dieser Leitfaden bietet einen operationalen Ansatz, um pragmatische Entscheidungen zu ASR, Audiohardware, Vorverarbeitungs‑Pipeline sowie Validierungs‑ und Betriebspraktiken zu treffen.
Ziel ist nicht eine universelle Lösung, sondern das Aufzeigen der abzuwägenden Kompromisse je nach Umgebungsprofil und geschäftlichen Zielsetzungen sowie die Bereitstellung von Checklisten und Runbooks, die Projektleitern, IT‑Verantwortlichen und Integratoren nutzbar sind.
Warum diese Entscheidung kritisch ist
Die Qualität der Spracherkennung bestimmt die Nutzbarkeit der Sprachschnittstelle. In ruhiger Umgebung liefern die meisten modernen ASR‑Systeme zufriedenstellende Ergebnisse. In lauten Umgebungen resultiert die Verschlechterung sowohl aus der Akustik und Mikrofonpositionierung als auch aus den Beschränkungen der ASR‑Engine.
Technische Entscheidungen haben zudem nicht‑funktionale Auswirkungen: Latenz, Datenschutz der Audioströme, Betriebskosten und Wartungsaufwand. Deshalb ist es sinnvoll, die Gestaltung als eine Kette abhängiger Elemente zu betrachten: Audiosensoren, Vorverarbeitung am Edge, Übertragung zu einem Erkennungsdienst und Fallback‑UX.
Entscheidungsmatrix ASR: Edge vs. Cloud
Die erste strategische Wahl betrifft den Standort der ASR‑Engine. Cloud‑Verarbeitung bietet oft bessere Erkennung und schnelle Modellupdates, während Edge‑Lösungen Latenz reduzieren und das Übertragen von Audio an Dritte einschränken. Die richtige Wahl hängt vom Lärmprofil, den Datenschutzanforderungen und Netzbedingungen ab.
An Standorten mit zuverlässiger Konnektivität und akzeptablen Datenschutzbedingungen erleichtert die Cloud die Sprach‑ und Modellverwaltung. An Standorten mit kritischer Latenz, eingeschränkter Bandbreite oder hohen Datenschutzanforderungen kann ASR am Edge vorteilhaft sein, vorausgesetzt die Konfiguration ist entsprechend ausgelegt.
In der Praxis ist eine hybride Architektur häufig sinnvoll: Vorverarbeitung und Sprachaktivitätserkennung (VAD) lokal, Weiterleitung an Cloud‑ oder Edge‑ASR je nach Situation und Datenschutzrichtlinien. Diese technische Entscheidung sollte im Pflichtenheft und in Netzwerk‑SLAs formalisiert werden.
Mikrofone und Positionierung: Mono, Array und Platzierung
Die Wahl des Sensors ist ebenso entscheidend wie die Auswahl der ASR‑Engine. Richtmikrofone können in ruhiger Umgebung ausreichen, während Mikrofonarrays fortgeschrittene Techniken wie Spatial Filtering und Beamforming ermöglichen, die das Signal‑zu‑Rausch‑Verhältnis für die ASR deutlich verbessern.
Die physische Positionierung der Hardware beeinflusst die Aufnahmequalität: Höhe, Abstand zum Nutzer, Hindernisse und reflektierende Oberflächen sind bei der Installation zu berücksichtigen. Gehäusedesign und taktile Ergonomie sollten gemeinsam mit der Mikrofonplatzierung geplant werden, um akustische tote Zonen zu vermeiden.
Ein Mikrofon‑Array für laute Standorte in Betracht ziehen, um Beamforming und Echounterdrückung zu ermöglichen, je nach Hardwarekonfiguration.
Positionierung nah am Interaktionsbereich favorisieren und eine klare visuelle Markierung anbringen, die Nutzer dazu animiert, in Richtung des Sensors zu sprechen.
Standorte in der Nähe wiederkehrender Lärmquellen (Kasse, Lüftung, automatische Türen) vermeiden.
Audiovorverarbeitungs‑Pipeline: VAD, Rauschunterdrückung und Beamforming
Vor dem ASR sollten mehrere Verarbeitungsstufen angewendet werden, um die Qualität des Nutzsignals zu verbessern. Die Sprachaktivitätserkennung (VAD) verhindert das Senden kontinuierlichen Rauschens an die Engine und trägt zur Latenzkontrolle bei. Adaptive Rauschunterdrückung und Bandfilter stabilisieren das Signal.
Beamforming nutzt ein Mikrofonarray, um die Sprecherrichtung zu verstärken und seitliche Störgeräusche zu dämpfen. Je nach Hardware können diese Verarbeitungen lokal (Edge) oder in der Cloud ausgeführt werden. Es empfiehlt sich, die Architektur so zu gestalten, dass kritische Komponenten (VAD, Echounterdrückung) auch bei Verbindungsverlust verfügbar bleiben.
Wake Word, VAD und Umgang mit unbeabsichtigten Interaktionen
Die Kombination von Wake Word und VAD verbessert die Bedienbarkeit: Ein gut gewähltes Wake Word erlaubt aktives Zuhören, ohne permanent den Sprachstrom zu erfassen. Das Wake Word kann lokal ausgeführt werden aus Gründen der Privatsphäre und Reaktionsgeschwindigkeit, während die VAD die Sitzungsöffnung steuert.
UX‑Verhalten müssen so gestaltet sein, dass versehentliche Auslösungen in lauten Umgebungen reduziert werden: kurzes visuelles/akustisches Feedback bei Aktivierung, taktile Startoption für Sprache und die Möglichkeit, das Mikrofon über eine sichtbare oder physische Steuerung stummzuschalten.
Spracherkennung und mehrsprachige Strategie
Automatische Spracherkennung erleichtert den mehrsprachigen Empfang, kann aber durch Lärm und sehr kurze Äußerungen gestört werden. Zwei komplementäre Ansätze werden empfohlen: eine explizite Sprachauswahl über die Touch‑Schnittstelle zu Beginn der Interaktion und automatische Erkennung als Hilfestellung, wenn das Sprachsignal lang genug und stabil ist.
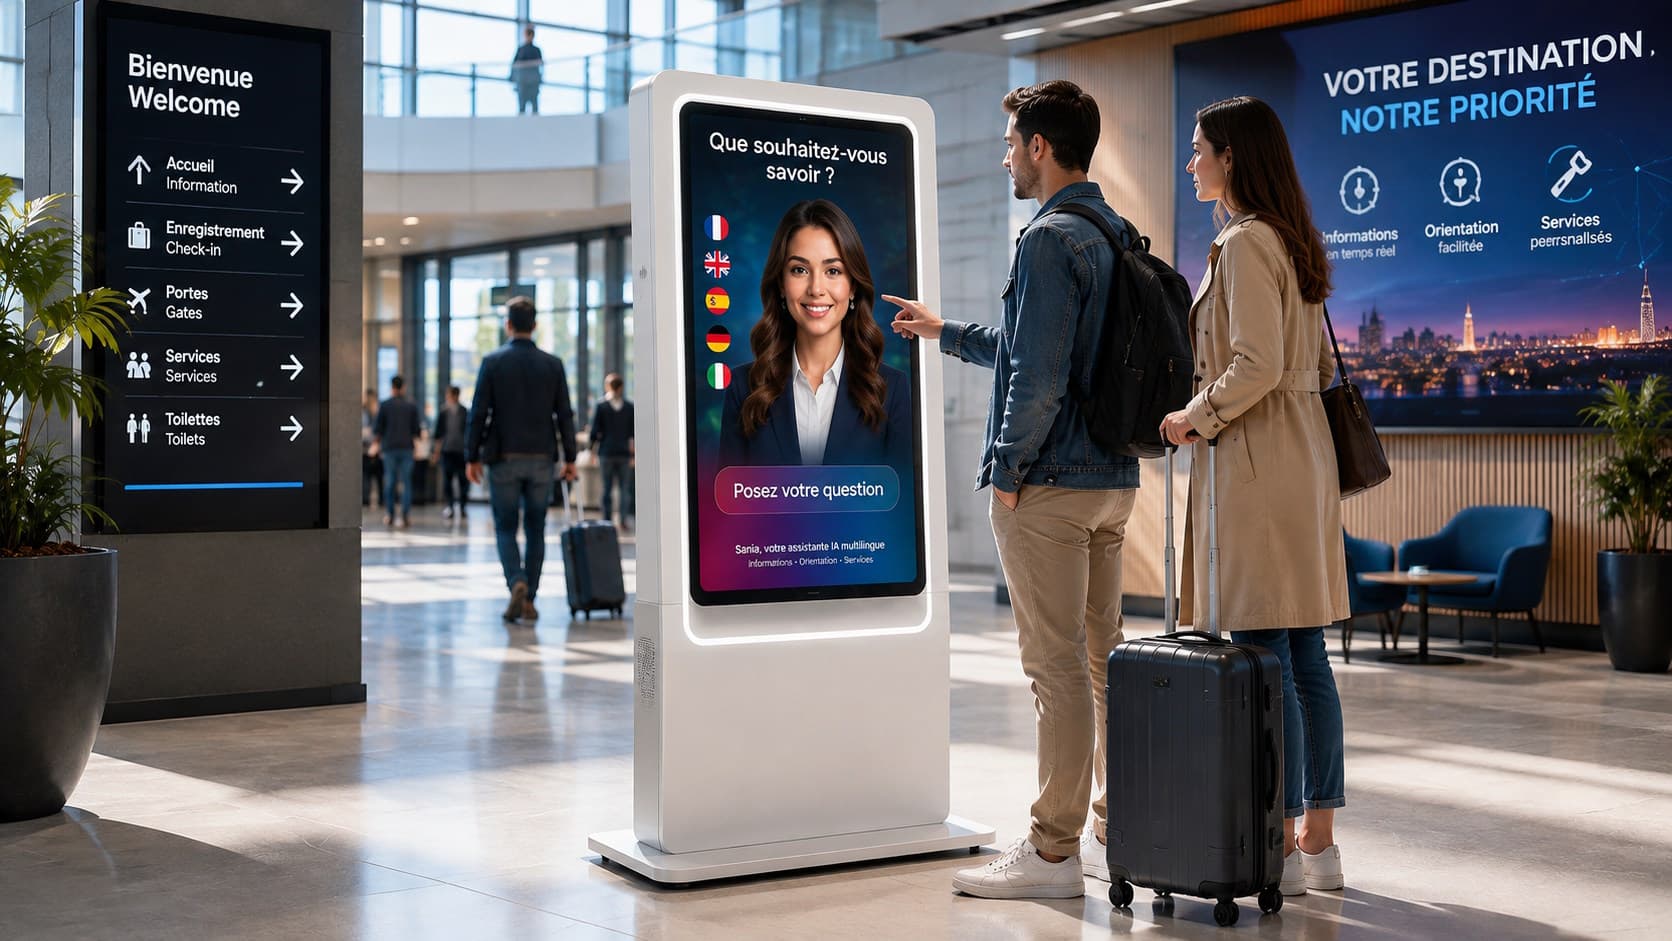
In jedem Fall sollte eine multimodale UX bevorzugt werden: verfügbare Sprachen anzeigen, schnellen taktilen Wechsel ermöglichen und sicherstellen, dass die fachliche Wissensbasis in den relevanten Sprachen aktuell ist. SANIA kann gemäß Konfiguration in mehr als 100 Sprachen kommunizieren, was die Umsetzung erleichtert, sofern die ASR‑Infrastruktur die Zielsprachen unterstützt.
Taktiler Fallback und multimodale Erfahrung
Kein Sprachsystem ist unter allen Bedingungen fehlerfrei. Ein taktiler oder visueller Fallback ist unerlässlich, um den Dienst zugänglich zu halten. Wenn die Konfidenz des ASR gering ist oder die Sprachaktivitätserkennung wiederholt versagt, muss die Oberfläche klar eine taktile Alternative anbieten.
Die UX sollte den Übergang Sprache→Touch nahtlos gestalten: Vorschlagsbuttons, kontextabhängige Menüs und vorausgefüllte Shortcuts verringern die kognitive Belastung. Die Avatar‑Persona kann den Nutzer zu diesen Alternativen führen, ohne die Interaktion abzubrechen.
Testprotokolle unter realen Bedingungen
Labortests reichen nicht aus: die Sprachkette muss vor Ort, zu Stoßzeiten und mit Muttersprachlern der Zielsprachen validiert werden. Repräsentative Szenarien (typische Fragen, Akzente, Sprechdauern) zusammenstellen und Interaktionen aufzeichnen für qualitative Analysen und gezielte Korrekturen.
Tests sollten Netzwerkresilienz, Latenz, Fehlalarme des Wake Words und plötzliche Lärmeinbrüche abdecken. Die Ergebnisse leiten die Kalibrierung der Audiopipeline, die Edge‑vs‑Cloud‑Entscheidung und die VAD‑Empfindlichkeit.
Wartung und 24/7‑Runbook: operative Checkliste
Zuverlässiger Betrieb verlangt klare Wartungsverfahren, die lokalen Teams oder Dienstleistern zugänglich sind. Das Runbook muss regelmäßige Prüfungen, Notfallmaßnahmen und Monitoring‑Vorgehen beschreiben, um kontinuierliche Verfügbarkeit sicherzustellen.
Präferieren Sie einfache, reproduzierbare Prozeduren und stellen Sie ferndiagnostische Mittel je nach Konfiguration bereit. Softwareupdates (Audio‑Treiber, Geräte‑Firmware, Vorverarbeitungs‑Komponenten) sind geplant zu verteilen und zu dokumentieren.
Sichtprüfung und Reinigung der Mikrofon‑ und Lautsprecherabdeckungen.
Netzwerk‑ und Stromverbindungen vor ASR‑Eingriffen prüfen.
Kontrolle lokaler Logs und regelmäßige Extraktion von Audiotraces, sofern die Datenschutzrichtlinie dies erlaubt.
Überprüfung der Softwarestände und kontrollierte Einspielung von Patches.
Verfahren zum Umschalten auf taktile Bedienung, falls ein anhaltender Audiofehler besteht.
Typische Konfigurationen je nach Lärmpegel
Zur Entscheidungsunterstützung hier praxisorientierte Empfehlungen nach akustischem Profil. Diese Hinweise sind allgemeiner Natur und sind an den konkreten Kontext anzupassen.
Geringer Lärm: Eine sprachliche Schnittstelle mit Richtmikrofon und Cloud‑ASR ist akzeptabel. Vorverarbeitung kann minimal sein, und UX kann Sprache als primäre Eingabe priorisieren.
Mittlerer Lärm: Ein Mikrofon‑Array mit Beamforming, lokale VAD und adaptive Rauschunterdrückung erhöhen die Robustheit. Eine hybride Architektur (lokale Vorverarbeitung, ASR in Cloud oder Edge) ist oft sinnvoll.
Hohe Störpegel: Bevorzugen Sie ein hochwertiges Array, fortgeschrittene lokale Verarbeitung, Wake Word am Edge und systematischen taktilen Fallback. Datenschutz kann zudem ein lokales Vorverarbeiten sensibler Segmente vor dem Versand empfehlen.
Kurze FAQ
F: Muss man für laute Orte immer ein Mikrofon‑Array wählen? A: Ein Array bringt technische Vorteile (Beamforming), verursacht aber höhere Hardwarekosten und erfordert strengere Integration. Es ist oft die effektivste Lösung für laute Umgebungen, die Entscheidung sollte jedoch durch erwartete Nutzung und Projektbudget begründet werden.
F: Wie messe ich, ob die Spracherkennung ausreichend für eine Abnahme ist? A: Neben technischen Messwerten sollten klare Abnahmekriterien im Pflichtenheft definiert und vor Ort mit repräsentativen Szenarien validiert werden. Diese Kriterien sollten wahrnehmbare Fehlerraten, Interaktionslatenz und die Fähigkeit der Nutzer, ihr Ziel per Sprache oder taktilem Fallback zu erreichen, umfassen.